Dicté en español y el modelo lo tradujo: voz en Linux con Handy y Herdr
A principios de agosto, ni Claude Desktop ni ChatGPT Desktop me dejaban controlar un agente con la voz en Linux. Armé algo con dos herramientas que ya existían, y lo interesante fueron los bugs.
El punto de partida
En Mac y Windows ya se podía. Según la demo de OpenAI, el modo voz de ChatGPT Desktop arranca agentes y hace un pull request completo mientras seguís hablando. Claude Desktop tiene Computer Use, pero solo en macOS. En Linux, ChatGPT Desktop no tenía build oficial y Claude Desktop había salido en beta el 30 de junio, sin dictado y sin Computer Use.
Claude Code sí tiene /voice en Linux. Pero manda el audio a los servidores de Anthropic, exige una cuenta de Claude.ai y no funciona por SSH. Yo quería lo contrario: dictado local, en español, sin depender de una nube.
Adoptar, no construir
La decisión fue no escribir nada propio. Handy es una app de dictado open source. Herdr es el orquestador de terminales que ya usaba. El texto transcrito se pega en el pane que tengo enfocado, sin plugin y, en ese momento, sin enviarlo: auto_submit en false. Una transcripción equivocada no debería ejecutar nada sola.
Para el reconocimiento elegí Parakeet V3, para no competir por VRAM con los otros modelos locales de la máquina.
Ctrl+Space funcionaba una sola vez
El atajo hold-to-talk dejaba de emitir eventos después del primer ciclo de grabación. Con Ctrl+Space, en mi GNOME sobre X11, el primer dictado andaba y el segundo no registraba nada.
Probé soltar los modificadores con un script externo, que sacó el Ctrl trabado pero no arregló la captura. Probé el backend handy_keys:
Failed to register handy-keys shortcut transcribe during initLo que funcionó fue una tecla sin modificadores. Pasé a F8 con el backend tauri, y dos dictados seguidos anduvieron.
Parakeet respondió en ruso
Con una muestra de un segundo, un "hola" salió como Оля.. El log confirmaba que el idioma configurado era español (language=Some("es")), así que no era un problema de configuración sino de decodificación sobre un audio demasiado corto. Con frases completas desapareció. Ese mismo día pasé a Canary 180M Flash, de 208 MiB, que ofrecía el mejor equilibrio entre velocidad y precisión del catálogo de Handy.
Las tildes que no llegaban
El texto se pegaba con xdotool type --delay 0, y bajo escritura rápida se comía las tildes y las eñes: señal salía como seal y envía como enva. Con --delay 12 se arregló.
El modelo que traducía
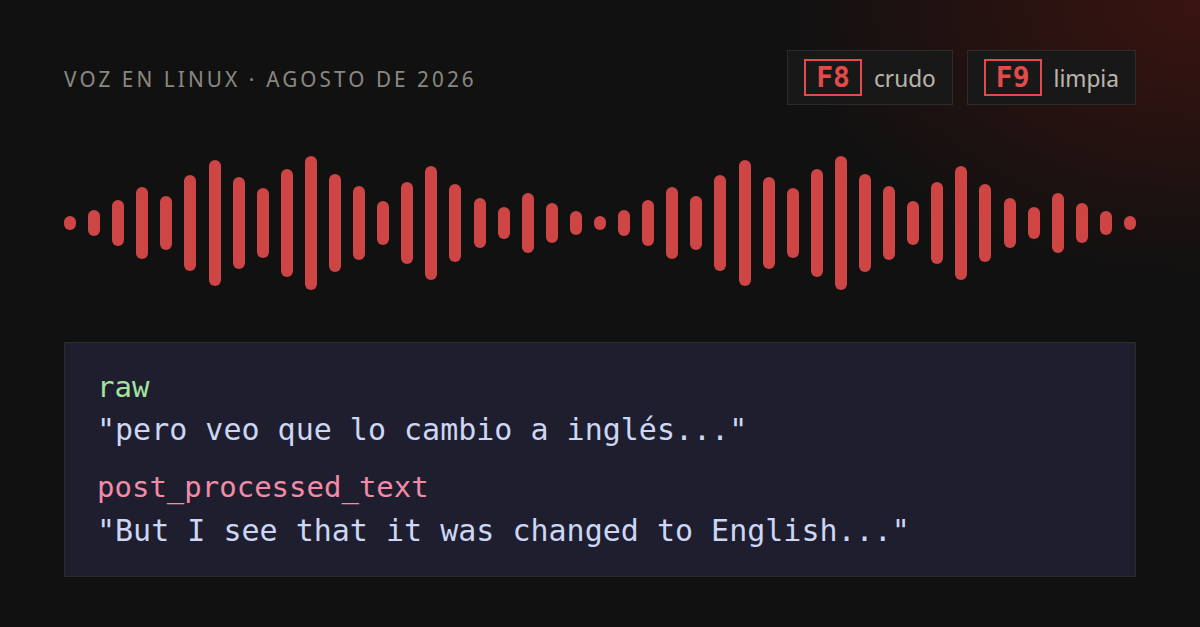
Handy puede limpiar la puntuación con un modelo de lenguaje. Elegí qwen-flash, un modelo chico y rápido. Dicté en español y esto fue lo que pegó:
raw (Canary):        "pero veo que lo cambio a inglés, eso es correcto..."
post_processed_text: "But I see that it was changed to English. Is that correct..."
El prompt por defecto ya decía "keep the language in the original version". No alcanzó.
Un modelo rápido y barato no siempre respeta una instrucción de "no traducir" mencionada una sola vez entre otras cinco reglas, sobre todo si el resultado "suena más natural" en inglés. La instrucción crítica la repetí en tres puntos del prompt: al inicio como regla de máxima prioridad, en la línea original y en el cierre ("same language as the input, no translation"). Verificado con varios dictados en español después.
El post-proceso que no aparecía
La sección de Settings para configurar el post-proceso no se veía aunque post_process_enabled estuviera en true. Estaba detrás de experimental_enabled, que viene en false.
Cuando apareció, F8 seguía devolviendo texto crudo. El post-proceso tiene su propio binding, transcribe_with_post_process, que reasigné a F9. La pista real estaba en el log:
Post-processing skipped because no prompt is selectedMedir antes de optimizar
Quise bajar la latencia del flujo F9. Antes de tocar nada medí siete dictados seguidos con los timestamps del log:
- De
TranscribeAction::stopa la respuesta del modelo remoto: de 1 a 1,2 segundos típico, con un pico de 2. - De la respuesta a
Text pasted successfully: de 120 a 240 milisegundos, según el largo del texto. - Tras 5 minutos sin usar, recargar el modelo local agrega demora, pero solo en el primer dictado.
Casi toda la latencia es la llamada de red al modelo de limpieza. Optimizar el pegado habría sido optimizar la parte que no pesa.
Canary y las tomas vacías
Canary funcionaba bien con frases cortas, pero en tomas de entre 7 y 40 segundos devolvía texto vacío:
0.28s for 22.32s of audio (78.42x real-time)
Transcription result is empty
Cuando funcionaba corría a unas cinco veces el tiempo real. Los casos vacíos corrían a entre 70 y 100 veces. Mi lectura es que no estaba transcribiendo, sino descartando el audio: una velocidad "demasiado buena" en una toma larga es una señal de fallo, no de rendimiento.
Pasé a Whisper Small. Y Whisper en modo automático elige un solo idioma por toma: un clip en inglés con acento salió en español. Fijé el idioma.
Dónde está hoy
El flujo de agosto era dictar en español, limpiar con F9 y pegar en un pane de Herdr. Hoy ya no es ese. El modelo es Whisper Small con el idioma fijo en inglés, y el F9 usa un prompt english_coach: lo uso para practicar inglés hablado.
El envío ahora es automático (auto_submit en true). En agosto lo dejé manual; lo cambié por practicidad.
Del lado de las apps oficiales, ChatGPT Desktop sacó un preview para Linux el 11 de agosto. Claude Desktop sigue sin dictado ni Computer Use en Linux, hasta donde pude verificar.
En cada bug de esta lista la respuesta estaba en el log o en el código fuente, y no en la documentación. Lo que me ahorró tiempo fue leerlos antes de cambiar nada.