El monitor se cayo con lo que monitoreaba. Tres semanas despues, sigo esperando el cupo que nunca llego.
El 17 de agosto a la noche me llegaron como veinte alertas de Telegram en cascada.
Distintos servidores, cada dos o tres minutos: netcup-vps, rpi-litellm, prometheus, rpi-homelab, oracle-vps. Patron FIRING/RESOLVED, uno atras del otro, entre las 21:26 y las 21:59. Empece a revisar uno por uno.
El sospechoso equivocado
Primera hipotesis: Tailscale haciendo flapping entre conexion directa y DERP relay - un patron de "churn" normal de NAT traversal que a veces se confunde con caida real. La descarte revisando journalctl de NetworkManager y dmesg en los hosts: cero eventos reales de desconexion.
Netcup y el RPi homelab estaban arriba, sin reboot. oracle-vps si mostraba 100% de packet loss y timeout de SSH en un chequeo puntual - ahi puse el foco.
El verdadero problema: el monitor se cae con lo que monitorea
Prometheus y Alertmanager - los servicios que mandan las alertas - corren en el mismo Oracle VPS que estan monitoreando (~/observability-hub/docker-compose.yml). Cuando ese host se pone inestable, el monitor no puede scrapearse a si mismo ni a los demas, y dispara InstanceDown en cascada para hosts que estan perfectamente sanos. Es un single point of failure clasico: el vigia se queda ciego justo cuando mas hace falta que vea.
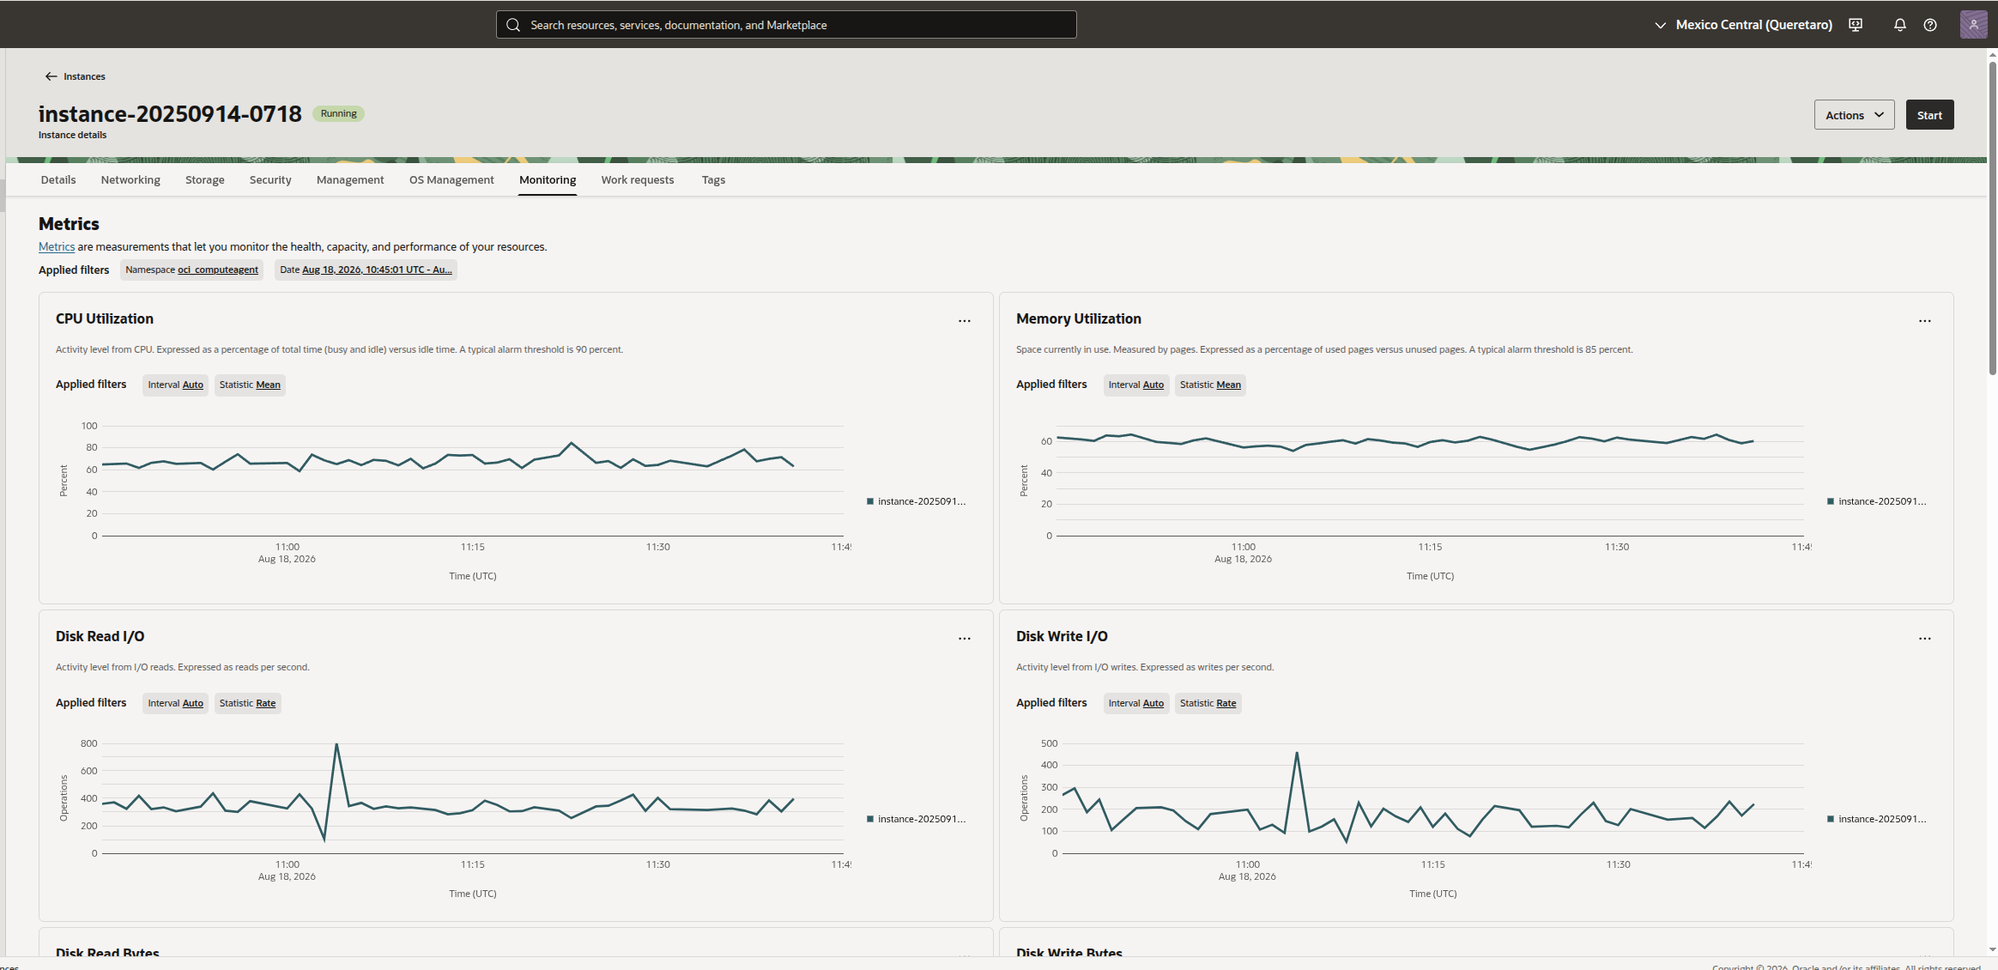
Verifique en la consola de Oracle Cloud: la instancia figuraba "Running", shape VM.Standard.E2.1.Micro (1 OCPU / 1GB, Always Free), y las metricas nativas de Monitoring (CPU, memoria) se veian sanas y estables.
Un plot twist propio: mi conexion desde la sandbox tenia blips intermitentes hacia el VPS. No era el servidor - lo confirme cuando el SSH desde mi maquina de siempre funciono sin problema. Pero las notificaciones seguian llegando, asi que el problema real seguia sin explicar.
Diagnostico: docker ps tardo 3 minutos en responder
Con el SSH andando, docker ps tardaba mas de tres minutos en devolver algo. Eso llevo a mirar el estado interno de verdad:
top -bn1 | head -5top - 11:08:40 up 105 days, 11:38, 1 user, load average: 15.32, 16.01, 15.11
Tasks: 161 total, 2 running, 149 sleeping, 0 stopped, 10 zombie
%Cpu(s): 0.6 us, 2.3 sy, 0.0 ni, 0.0 id, 36.5 wa, 0.0 hi, 0.0 si, 60.7 st
MiB Mem : 956.6 total, 66.8 free, 410.9 used, 479.0 buff/cache
MiB Swap: 2048.0 total, 1393.6 free, 654.3 used. 397.4 avail MemLoad average de 15-16 en una maquina de 1 OCPU. Pero ningun proceso propio explicaba esa carga - el mas pesado, un container de monitoreo, apenas llegaba al 5.6% de CPU.
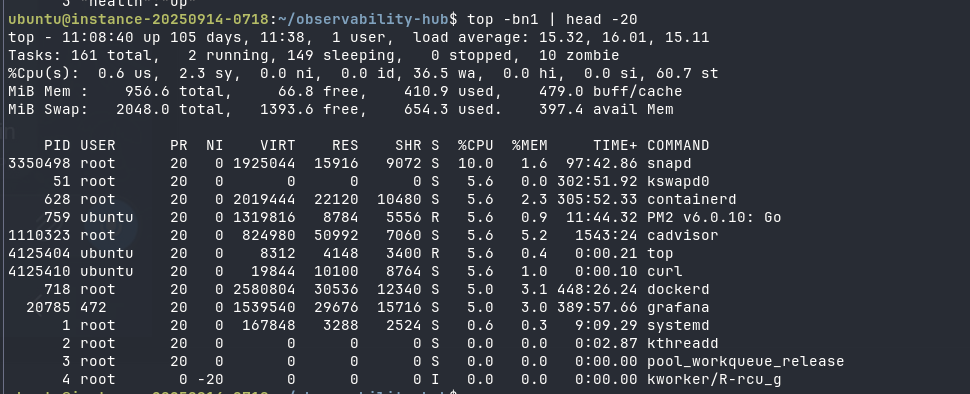
Es la columna
st: steal time. Es el porcentaje de ciclos de CPU que el hypervisor le quita a tu VM para dárselos a otro inquilino del mismo host fisico. Con 60.7% de steal, la mayoria del tiempo mi VM pedia CPU y el hypervisor se la daba a otro primero. Un load average alto con procesos propios livianos no es evidencia de "tengo que optimizar mi codigo" - es contencion del host fisico, mas comun en tiers free/compartidos que en instancias dedicadas.
La decision: migrar
Vecino ruidoso confirmado, la unica salida real era sacar el stack de un tier tan sobrevendido. Oracle ofrece una segunda linea de Always Free separada de la E2.1.Micro: Ampere A1.Flex, hasta 2 OCPU / 12GB (Oracle redujo ese cupo de 4 OCPU/24GB a 2 OCPU/12GB el 15 de junio de 2026 sin aviso previo - coincidio con una notificacion real que aparecio en la consola justo ese dia).
Ese mismo dia arranque el tramite. "Out of host capacity" - mismo error 500 con el que ya habia peleado dias para conseguir la instancia E2.1.Micro original.
20.992 intentos y contando
Antes de escribir un retry loop propio, revise si ya existia algo: mohankumarpaluru/oracle-freetier-instance-creation (517 estrellas, activo a julio 2026) contra hitrov/oci-arm-host-capacity (1303 estrellas, pero archivado desde 2024). Adopte el primero.
Configurarlo local trajo sus propios gotchas:
- La auto-deteccion de subnet via metadata service solo funciona corriendo DESDE una instancia OCI. Corriendo desde una PC hay que resolver el subnet a mano con el SDK:
import oci config = oci.config.from_file("oci_config") net_client = oci.core.VirtualNetworkClient(config) subnets = net_client.list_subnets(compartment_id=config["tenancy"]).data - El shape A1.Flex viene hardcodeado en
main.pya 2 OCPU/12GB - no hay variable de entorno para pedir menos. - El nombre de Availability Domain que muestra la consola (
AD-1) no es el nombre real del recurso (hXXo:MX-QUERETARO-1-AD-1); el script matchea por sufijo, asi queAD-1funciona igual. - La notificacion de Telegram vive en el wrapper bash (
setup_init.sh), no enmain.py. Si corres el script Python directo para desacoplarlo de una sesion, la notificacion se pierde sin ningun error visible. - Migrar el repo de la PC al RPi via
rsync(mismo usuario, mismo$HOME, carpeta distinta) dejo paths absolutos rotos enoci_configyoci.env, en cascada: primeroConfigFileNotFound, despues de corregir eso,No option 'user' in section: 'DEFAULT'.
El script quedo corriendo cada ~60 segundos, alternando entre pedir 2 OCPU/12GB y 1 OCPU/6GB para no duplicar carga contra la API. Al dia de hoy: 20.992 intentos, todos con el mismo "Out of host capacity".
El segundo golpe
El 9 de septiembre, sin haber conseguido nunca la instancia nueva, el mismo Oracle VPS volvio a caerse. Esta vez no era steal time: un reset de la instancia hizo que los 8 containers del stack (postgres, prometheus, loki, alertmanager, grafana, cloudflared, node-exporter, promtail, mas cadvisor) reiniciaran todos juntos con restart: unless-stopped, sin limite de memoria, en una VM de 956MB de RAM.
La maquina entro en swap-thrashing. La intuicion obvia - "paro el container mas pesado para liberar RAM" - no funciono:
$ ssh host "docker ps"
# timeout, sin output, load average >10 en 1 vCPU

$ ssh host "echo hola"
hola
echo respondia. docker ps no. Cualquier comando que hable con el socket de dockerd - listar, actualizar, parar - queda en la misma cola saturada y cuelga por igual, sin importar que tan liviano parezca. El motivo: dockerd reinicia TODOS los containers con restart policy al arrancar, ignorando el orden de depends_on de compose (eso solo aplica a docker compose up, no al restart automatico del daemon). El propio proceso dockerd quedaba compitiendo por CPU/IO con los containers que estaba levantando, asi que ni su propia API respondia a tiempo.
La unica forma de intervenir fue pollear con comandos que no tocan el daemon (echo, cat, date) hasta encontrar una ventana donde respondieran rapido - eso indicaba que el daemon habia bajado de intensidad un momento. En esa ventana, disparar el comando docker real, aceptando que podia cortarse a mitad.
El fix real
Saque el contenedor mas pesado y menos necesario - cAdvisor, corriendo privileged: true, escaneando todo el filesystem y los cgroups del host constantemente para metricas por-container que ademas no se usaban en ningun dashboard:
docker rm -f cadvisorAl resto le puse limite de memoria, uno por uno, en la ventana que iba apareciendo:
docker update --memory=100m --memory-swap=200m postgres
docker update --memory=150m --memory-swap=300m prometheus
docker update --memory=100m --memory-swap=200m loki
docker update --memory=32m  --memory-swap=64m  alertmanager
docker update --memory=150m --memory-swap=300m grafana
docker update --memory=32m  --memory-swap=64m  cloudflared
docker update --memory=24m  --memory-swap=48m  node-exporter
docker update --memory=48m  --memory-swap=96m  promtail
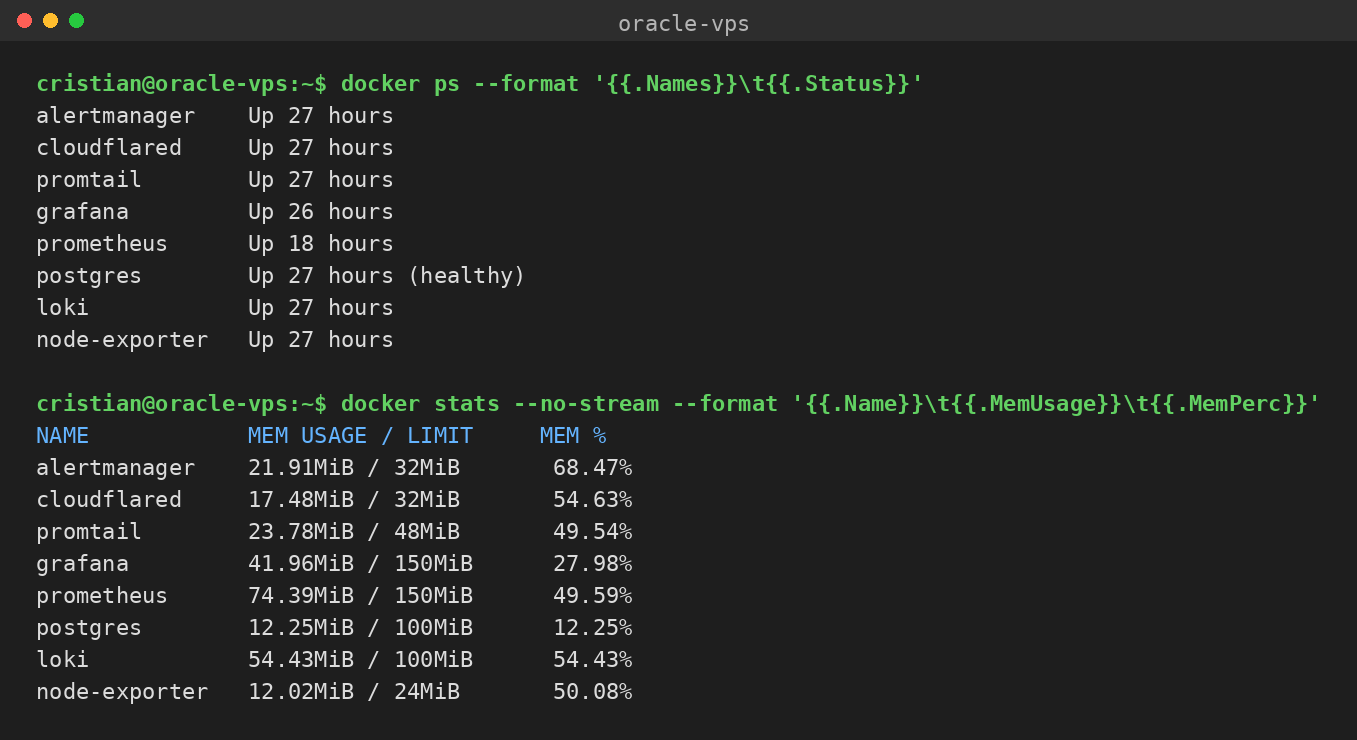
docker update --memory persiste el limite en el HostConfig del container ya existente - sobrevive reboots futuros sin tocar el docker-compose.yml ni recrear nada. Un dia despues, los 8 containers seguian arriba, cada uno dentro de su limite:
Lo que me queda
No conseguí la instancia A1.Flex. Sigo sin conseguirla mientras escribo esto. El plan original - migrar a un host mas grande y dejar de pelear contra los recursos del E2.1.Micro - sigue en una cola de reintentos que ya pasa los 20.900 y sube.
Mientras tanto, el problema real (self-monitoring en un host sobrevendido, memoria compartida entre demasiados servicios) no desaparecio: se volvio manejable. Un cAdvisor menos y ocho limites de memoria alcanzaron para que la misma maquina aguante otro reboot sin thrashing. No es la solucion que planee. Es la que tenia disponible.